이전 글에서 이어집니다.
앞면 뒷면
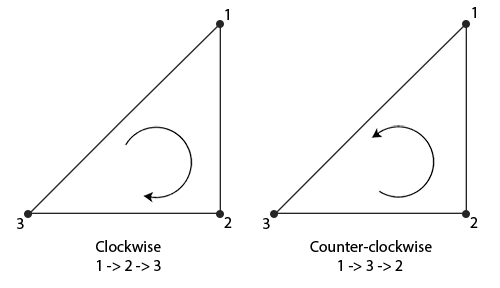
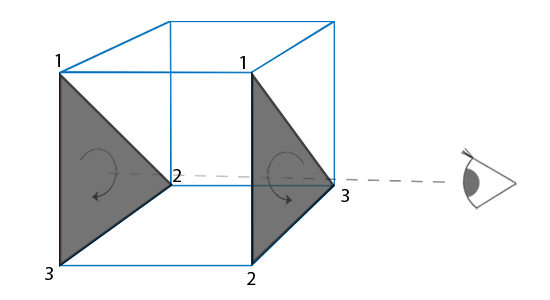
화면에 정육면체를 그린다고 생각해보자. 카메라를 향하지 않는 면은 굳이 그릴 필요가 없다. 이런 식으로 보이지 않아도 되는 프리미티브를 솎아내 그리지 않는 것을 컬링(Culling)이라고 한다. 그중 어떤 면이 향하는 방향에 따라 그리지 않는 것을 페이스 컬링(Face Culling)이라고 한다. 카메라를 향하는 앞면을 그리고, 뒷면을 안 그리는 것은 후면 컬링(Back-face Culling)이다. 정점의 순서를 기준으로 앞면과 뒷면이 정해진다. RenderPipeline의 PrimitiveState 설정 중 front_face로 앞면이 되는 정점 순서를 CCW(Counter Clockwise, 반시계 방향)와 CW(Clockwise, 시계 방향) 중에서 정할 수 있다. 이게 재미있는 게, 프리미티브가 회전하면 어느 순간 화면 기준 정점의 방향이 반대로 바뀌게 된다. GPU는 렌더 시 이를 다시 판별해 도형이 지금 뒷면인지 앞면인지 판단한다.
한편, 지금 그려내는 삼각형 하나에도 front_face 설정은 적용되어 있다. front_face는 기본적으로 CCW를 앞면으로 설정한다. 이때, 후면 컬링을 적용할지, 앞면 컬링을 적용할지 cull_mode로 정할 수 있다. 이전 글에서 cull_mode를 None으로 설정했는데, 이는 앞면과 뒷면을 모두 그리겠다는 의미다.
primitive: wgpu::PrimitiveState {
    topology: wgpu::PrimitiveTopology::TriangleList,
    cull_mode: Some(wgpu::Face::Back),
    ..Default::default()
},
cull_mode를 Back으로 바꾸면 뒷면은 그려지지 않게 된다. 나머지 설정은 기본값이라 front_face는 CCW, 즉 반시계 방향이 앞면이다.
fn vertex_main(@builtin(vertex_index) index: u32) -> @builtin(position) vec4f {
    let positions = array<vec4f, 3>(
        vec4f(-0.5, -0.5, 0.0, 1.0),
        vec4f(0.5, -0.5, 0.0, 1.0),
        vec4f(0.0, 0.5, 0.0, 1.0),
    );
    return positions[index];
}
현재 정점은 반시계 방향이기에 cull_mode의 영향을 받지 않는다. 여기서 cull_mode를 Front로 바꾸면 화면엔 아무것도 그려지지 않게 되는 것이다.
정점 버퍼
지금은 정점 셰이더 함수 안에서 각 정점의 위치를 정해 사용하고 있다. 이를 셰이더 프로그램 밖에서 입력받아 사용할 수 있게 할 예정이다. 이를 위해 버퍼(Buffer)가 뭔지 알아야 한다.
버퍼는 데이터를 저장해두는 연속적 메모리 공간이다. 연속적이라는 말은 논리적으로 연속된 주소 공간이라는 뜻이다. 그 안에서 데이터끼리 떨어져 있어도 된다. 그러한 데이터 사이의 틈을 패딩(Padding)이라고 한다. 떨어져 있는 건 데이터끼리이지 버퍼 공간 자체가 아니다. 버퍼는 논리적으로 연속적이다. GPU는 버퍼 시작 위치에서 몇 바이트 떨어져 있는지(Offset)를 기준으로 데이터에 접근한다. 그렇기에 GPU가 버퍼 안 데이터의 위치에 바이트 단위로 올바르게 접근할 수 있어야 한다.
지금은 삼각형 하나를 그린다. 그러나 수많은 삼각형을 그린다면 모든 정점 위치를 셰이더 코드 내에 작성하는 일은 고되다. 따라서 준비한 정점들을 버퍼에 저장해 놓고 GPU가 읽어서 사용할 수 있게 하는 것이다. 어떤 데이터를 저장하고 사용하느냐에 따라 버퍼의 종류가 달라진다. 정점 데이터를 저장하는 버퍼는 정점 버퍼(Vertex Buffer)다. 우선 정점 버퍼에 담을 정점 데이터가 필요할 테다. 이를 위해 Rust 코드에서 Vertex라는 구조체를 만든다.
#[repr(C)]
struct Vertex {
    position: [f32; 2],
    uv: [f32; 2],
    color: [f32; 3],
}
Vertex의 필드로 32비트 부동소수점 값 2개를 가지는 position과 uv, 그리고 3개를 가지는 color를 선언한다. position은 클립 공간의 정점 좌표이고, uv는 position을 0~1 범위로 옮긴 값이며, color에는 아무 색상이나 넣는다. 사실 position 하나면 되지만 이전 글에서 GPU가 정점별 부동소수점 값을 보간해 프래그먼트를 생성한다고 했으니 이를 시험할 것이다. #[repr(C)]는 C의 구조체 메모리 배치 규칙을 따르도록 만드는 속성이다. 필드의 메모리 배치 순서가 선언 순서로 고정되어 컴파일러가 임의로 필드 순서를 변경할 수 없게 된다. 이를 통해 각 필드의 메모리 위치(오프셋)를 예측할 수 있으며, GPU가 버퍼에서 지정된 위치의 데이터를 올바르게 읽도록 할 수 있다.
impl Vertex {
    fn new(position: [f32; 2], uv: [f32; 2], color: [f32; 3]) -> Self {
        Vertex {
            position: position,
            uv: uv,
            color: color,
        }
    }
}
함수를 만들어 생성을 간략화한다.
let vertices = [
    Vertex::new([-1.0, -1.0], [0.0, 0.0], [1.0, 0.0, 0.0]),
    Vertex::new([1.0, -1.0], [1.0, 0.0], [0.0, 1.0, 0.0]),
    Vertex::new([1.0, 1.0], [1.0, 1.0], [0.0, 0.0, 1.0]),
    Vertex::new([-1.0, -1.0], [0.0, 0.0], [1.0, 0.0, 0.0]),
    Vertex::new([1.0, 1.0], [1.0, 1.0], [0.0, 1.0, 0.0]),
    Vertex::new([-1.0, 1.0], [0.0, 1.0], [0.0, 0.0, 1.0]),
];
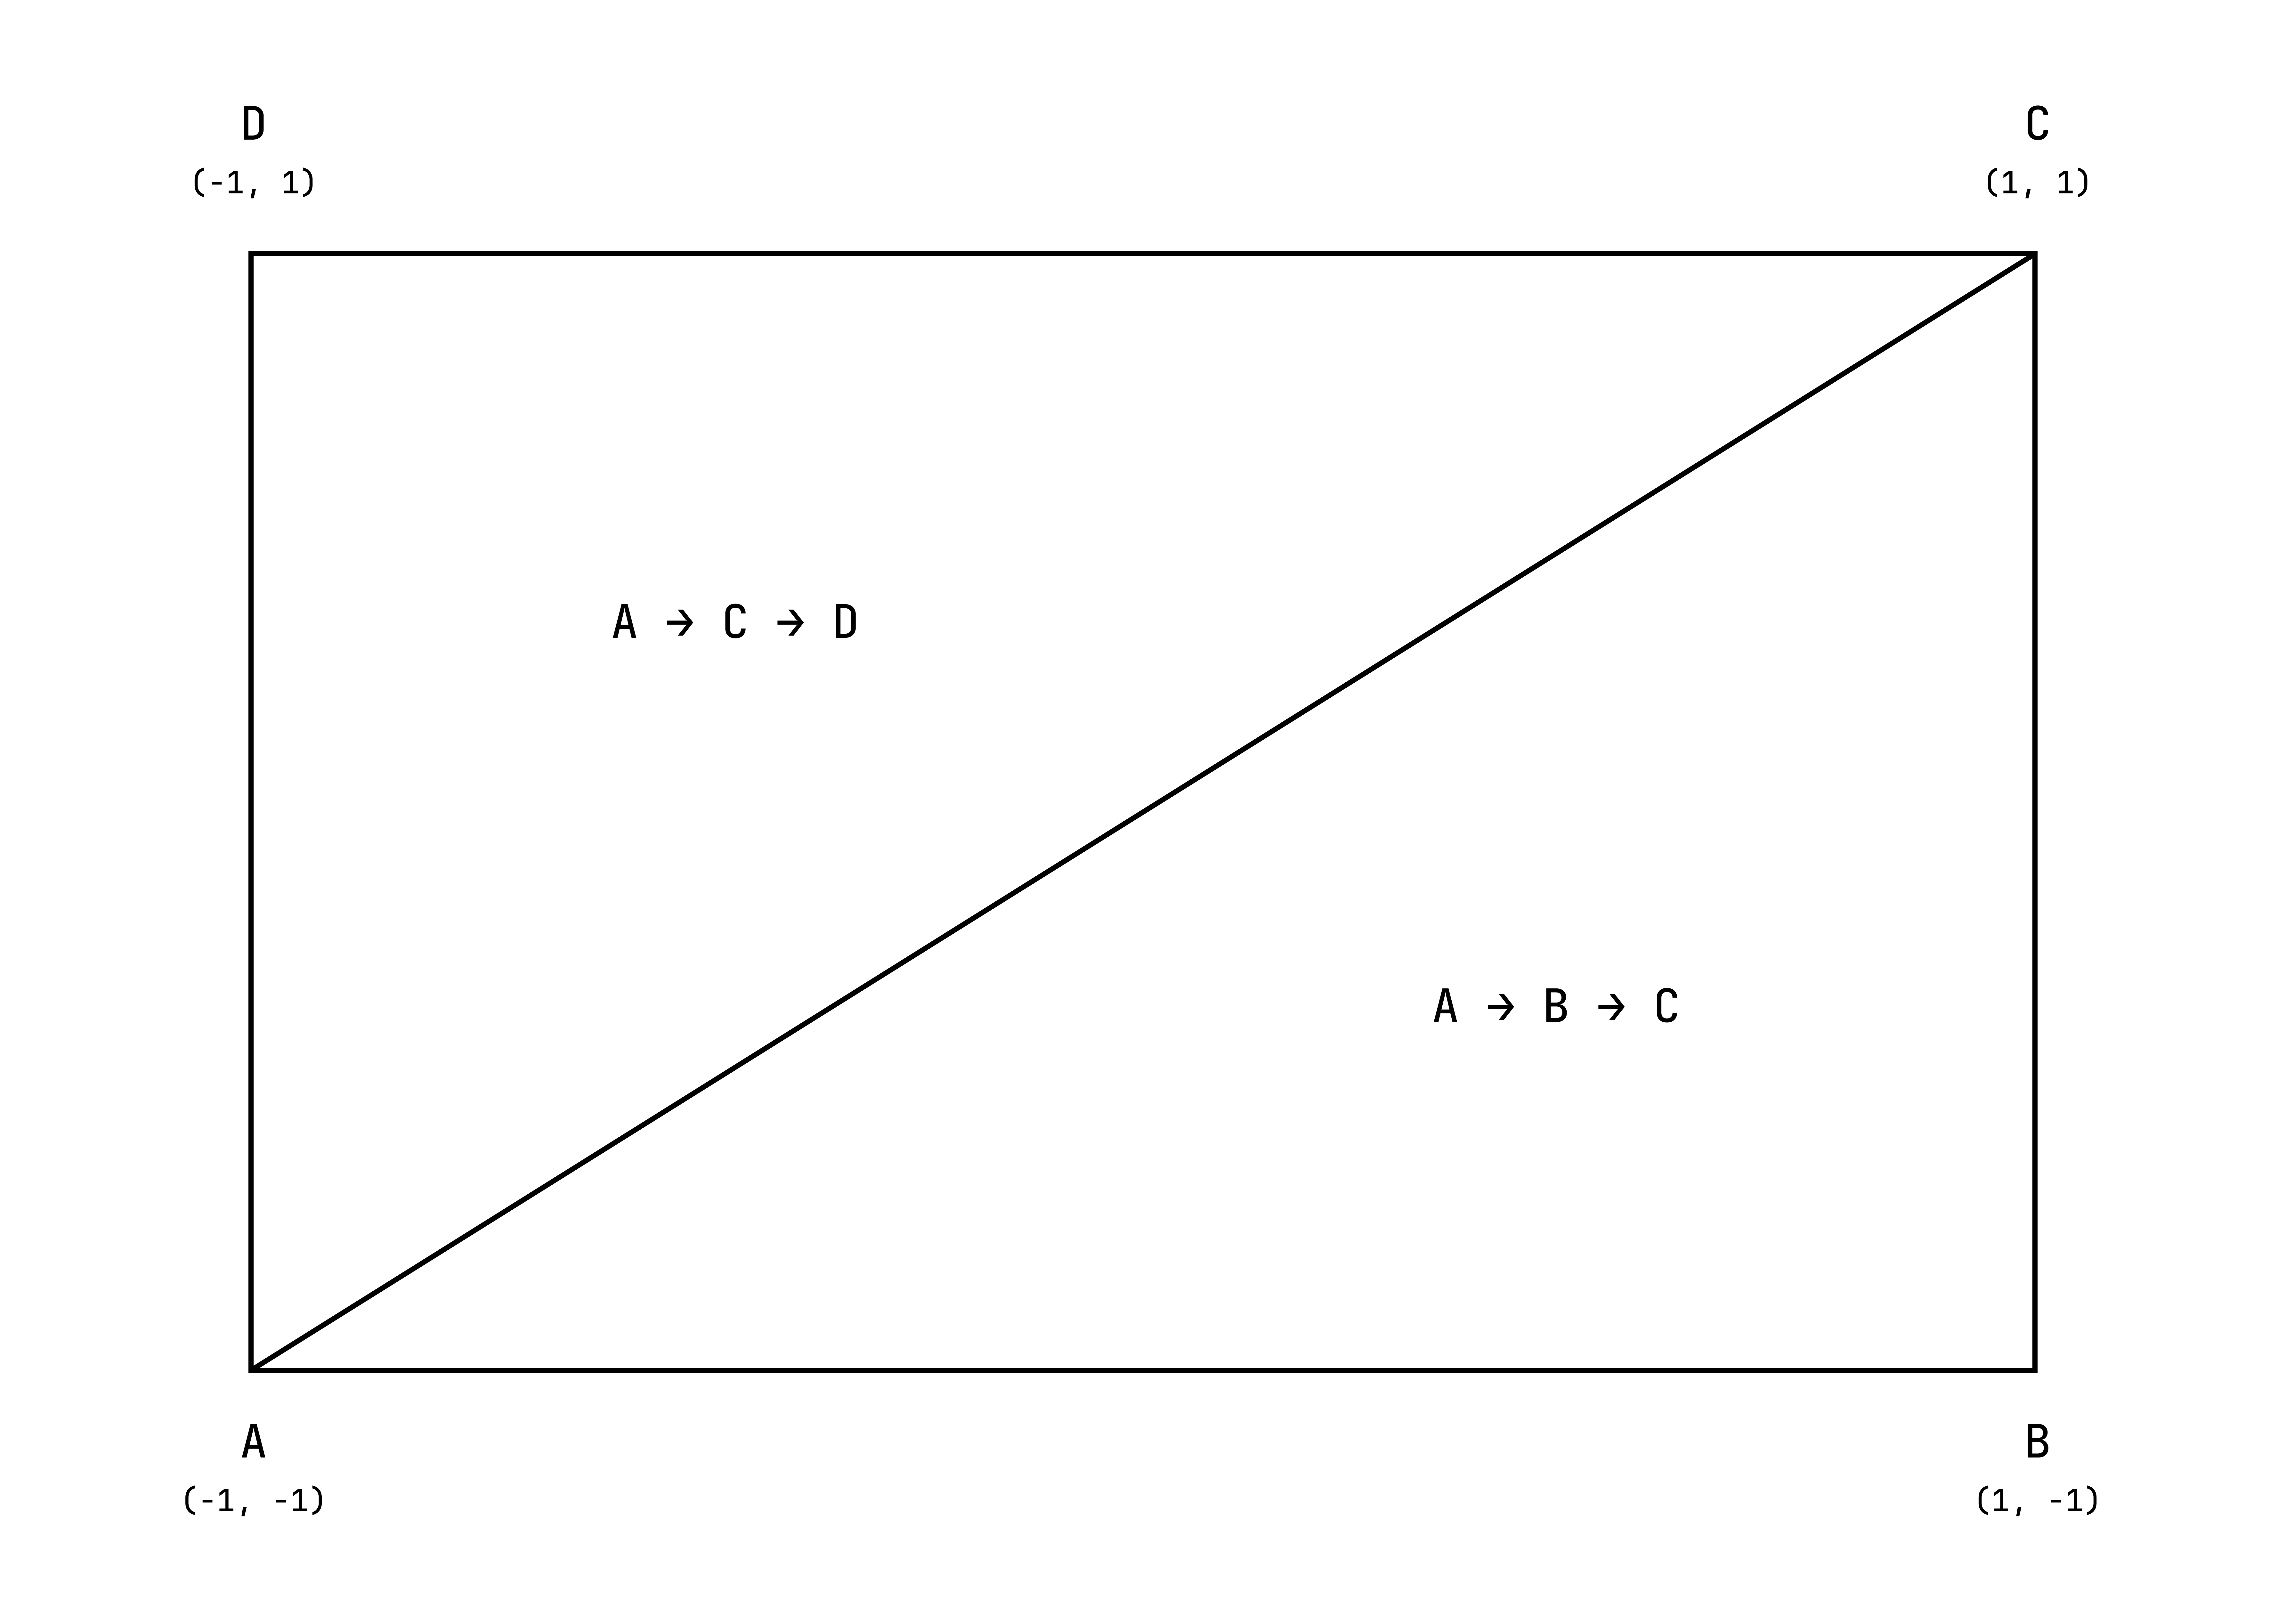
삼각형 두 개로 화면을 전부 덮을 것이다. 현재 PrimitiveState의 topology는 정점 3개마다 독립된 삼각형을 그리는 TriangleList다. 또, 현재 앞면만 그리고 있는데, CCW가 앞면이니 정점 6개를 반시계 방향으로 만들어 배열에 담는다.
use wgpu::util::DeviceExt;let vertex_buffer = device.create_buffer_init(
&wgpu::util::BufferInitDescriptor {
label: Some("vertex_buffer"),
contents: bytemuck::cast_slice(&vertices),
usage: wgpu::BufferUsages::VERTEX,
},
);정점 버퍼는 Device의 create_buffer 메서드로 만든다. 버퍼를 원하는 형식과 크기로 만든 후 Queue의 write_buffer로 실제 데이터를 넣어야 한다. 혹은 create_buffer_init을 사용할 수 있다. 이는 버퍼의 생성과 초기화를 함께 수행한다. 이 메서드는 DeviceExt라는 trait이 제공하는 메서드다. 따라서 해당 trait을 use로 가져와야 한다.
BufferInitDescriptor의 contents와 usage를 설정해야 한다. usage는 말 그대로 해당 버퍼의 용도다. 정점 데이터를 담는 정점 버퍼로 사용할 예정이니 BufferUsages를 VERTEX로 설정한다.
contents는 꽤 중요하다. 버퍼에 넣을 데이터로 u8(부호 없는 8비트 정수), 즉 1바이트 단위 슬라이스의 참조를 받는다. 앞서 이야기했듯 GPU는 바이트 단위로 메모리의 특정 위치에 접근한다. 따라서 vertices 배열의 데이터를 바이트 단위로 읽을 수 있게 변환해야 한다.
바이트 메모리
cargo add bytemuck --features derive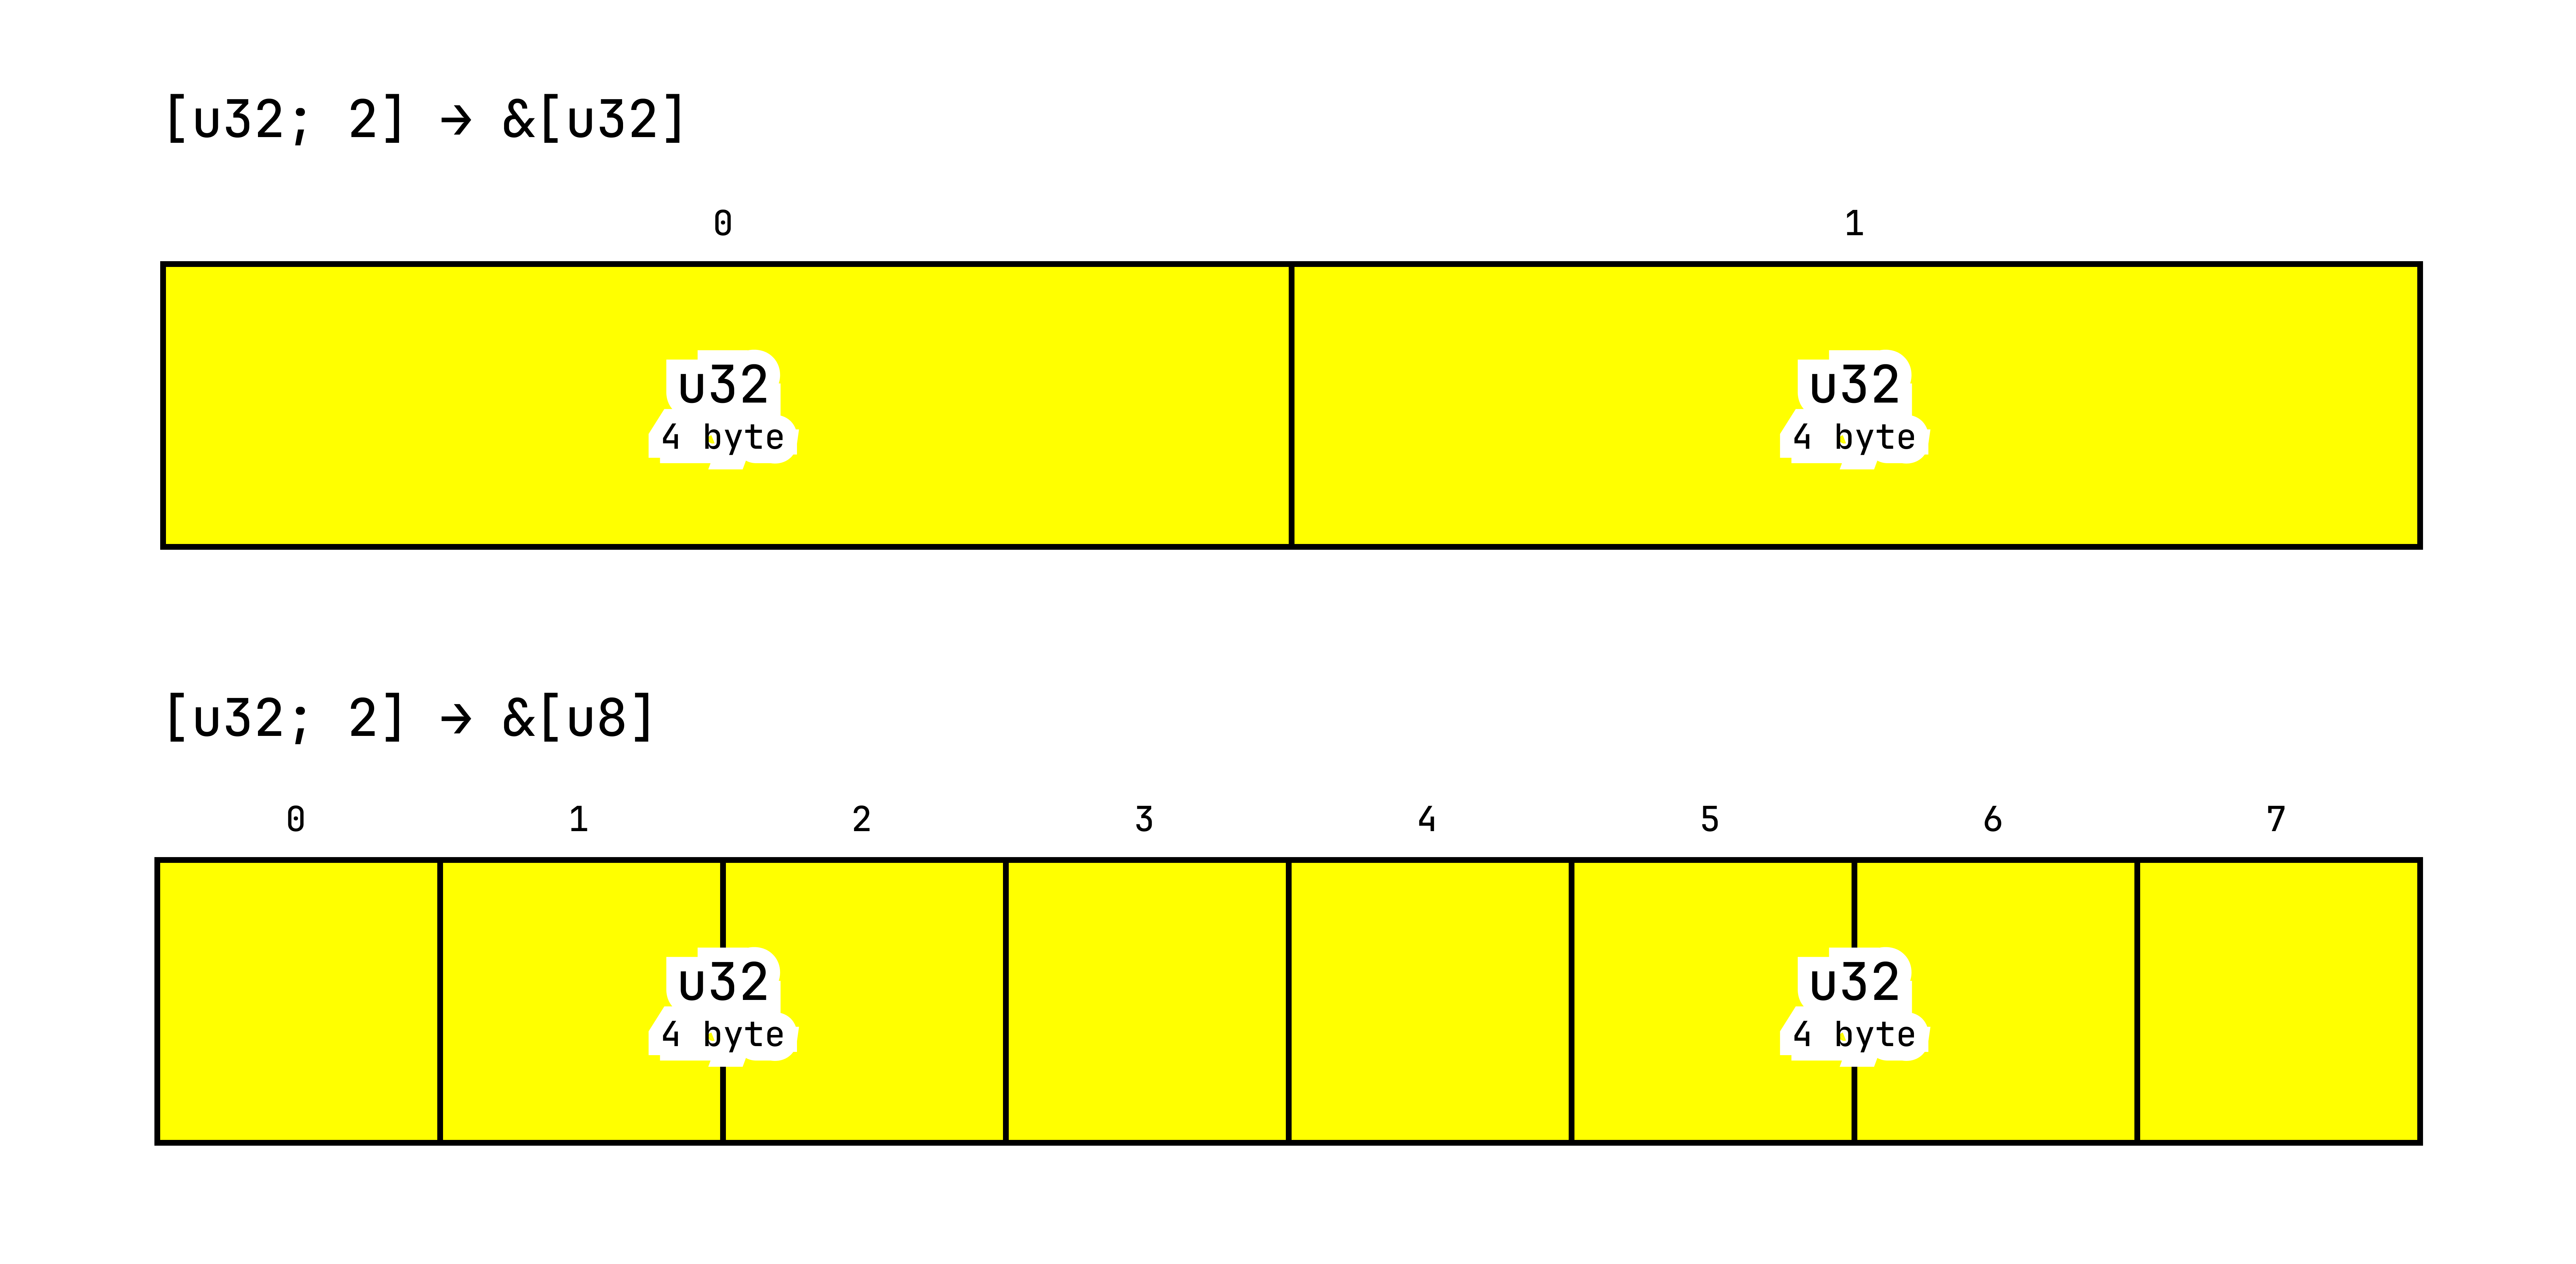
이때 사용되는 라이브러리가 bytemuck이다. 이는 같은 메모리를 읽되, 한 요소를 몇 바이트로 읽고 어떤 타입의 값으로 해석할지 정할 수 있게 한다. Vertex 하나는 f32x2가 2개, f32x3이 하나로 총 28바이트다. vertices 배열은 Vertex 6개로 구성된다. 그렇다면 vertices는 u8(1바이트) 단위로는 168바이트가 된다. bytemuck의 cast_slice는 슬라이스 참조를 입력받아 다른 타입의 슬라이스 참조를 반환한다. 물론 데이터 자체를 변경하는 게 아니라 데이터에 접근하는 단위와 타입이 다른 참조를 만들어 주는 것이다.
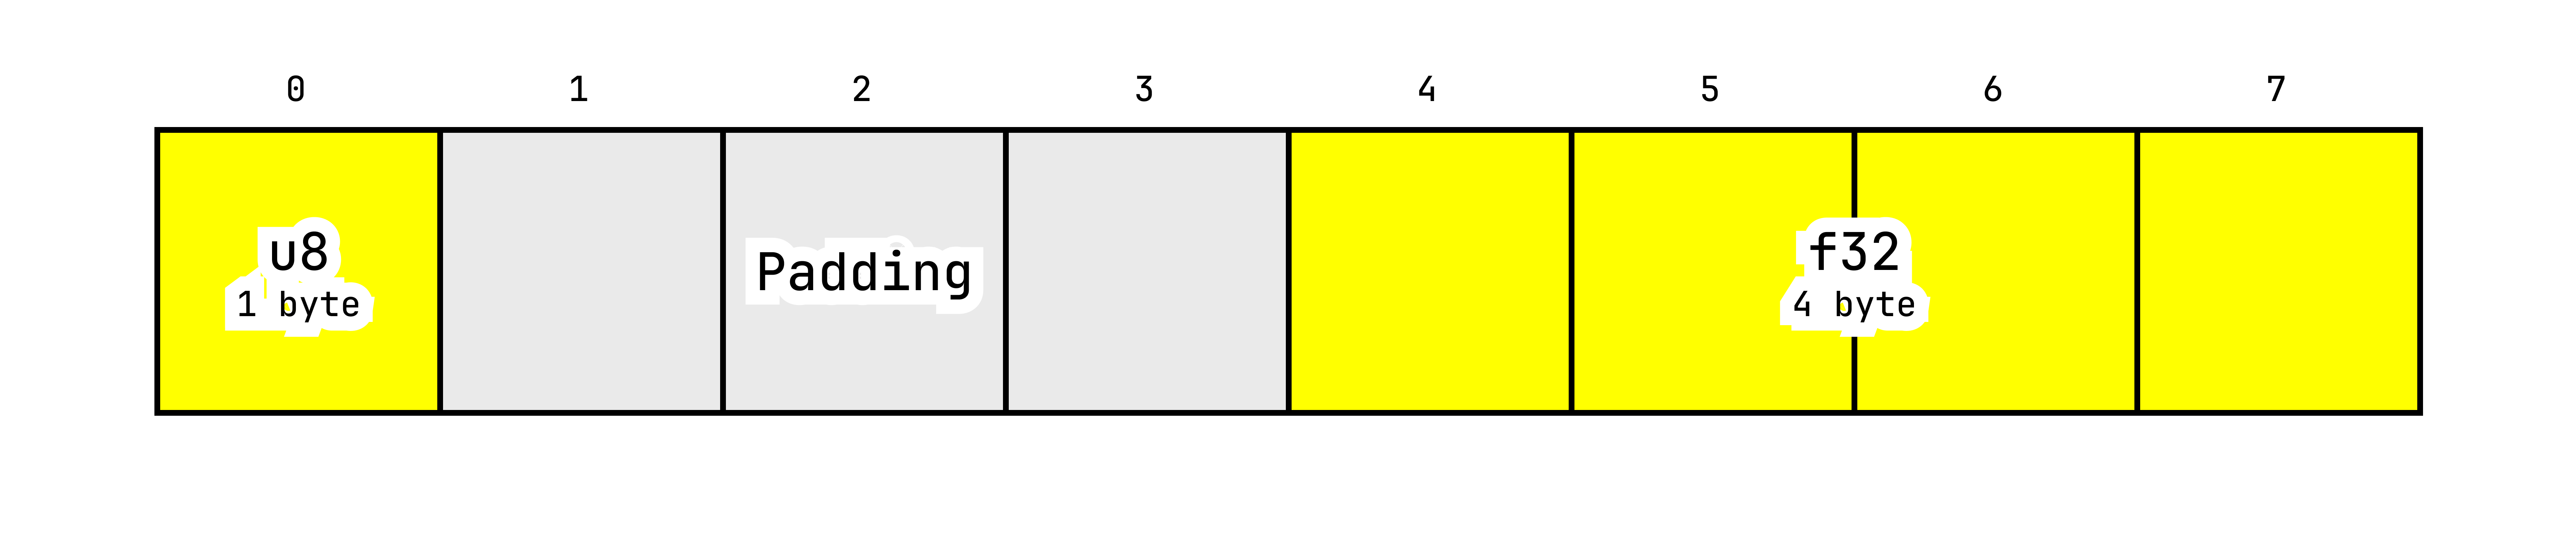
값은 메모리에 저장될 때 메모리 정렬 규칙을 따른다. 각 값은 그 타입 정렬 단위의 배수인 주소에서 시작한다. f32의 정렬 단위는 4바이트다. u8은 1바이트, u64는 8바이트다. u8 하나와 f32 하나로 구성된 구조체의 정렬 단위는 필드 중 가장 큰 정렬 단위를 따라 4바이트다. 필드 크기를 더하면 5바이트다. 그런데 u8 바로 뒤인 오프셋 1은 f32의 정렬 조건(4의 배수)에 맞지 않아서, f32의 시작 위치가 오프셋 4로 밀린다. 이렇게 앞 필드 뒤에 생기는 빈 공간이 패딩(Padding)이다. 여기서는 3바이트의 패딩이 생겨 구조체의 실제 크기는 8바이트가 된다. 또한 구조체 전체 크기는 정렬 단위의 배수가 되어야 하므로, 필드 순서에 따라서는 마지막 필드 뒤에도 패딩이 생길 수 있다.
구조체를 GPU에 전달하려면 이를 바이트 단위 슬라이스로 바라봐야 한다. 이때 초기화되지 않은 패딩이 존재하면 해당 바이트를 안전하게 읽을 수 없다. 패딩은 메모리 공간을 차지하지만, 그 바이트 값은 일반적으로 의미 있는 데이터로 보장되지 않기 때문이다. bytemuck의 Pod(Plain Old Data)는 패딩이나 초기화되지 않은 바이트가 없고, 모든 비트 패턴(8비트 기준 00010010 같은 경우의 수)이 해당 타입에서 유효하도록 보장하는 trait이다. Pod를 derive한 구조체에 패딩이 있으면 컴파일 오류가 난다. 이를 통해 해당 구조체의 메모리가 안전하게 바이트 데이터로 취급될 수 있게 보장한다.
왜 Pod가 필요한지 납득이 안 됐다. 패딩이라는 건 내가 명시한 필드의 값과 무관한 잉여 메모리 영역을 의미한다. 그곳에는 의도하지 않은 어떤 비트 패턴이 들어 있다. 그럼 그냥 해당 비트 패턴의 값으로 읽게 하면 상관없지 않나 싶었다. 어차피 패딩을 명시적으로 건너뛰고 값을 읽게 하면 내 의도대로 작동하는 셈이니까. 그러나 Rust는 초기화되지 않은 바이트를 임의의 값으로 읽는 것을 보장하지 않는다. 패딩 바이트 메모리에 10101010이 들어 있어 u8 타입의 170으로 읽는다고 해도, Rust 차원에선 해당 메모리가 초기화되지 않았기 때문에 비트 패턴이 존재하고 값으로 읽을 수 있는지 여부와 무관하게 규칙에 어긋난 동작으로 여긴다. 그렇기에 Pod로 해당 타입의 메모리 배치엔 패딩이 없도록 보장하는 것이다.
// 예시
struct Foo {
    a: u8,
    padding: [u8; 3],
    b: f32,
}
따라서 구조체를 바이트 슬라이스로 전달할 때 패딩이 생긴다면 명시적으로 필드를 선언해 메꿔줘야 한다.
#[repr(C)]
#[derive(Copy, Clone, bytemuck::Pod, bytemuck::Zeroable)]
struct Vertex {
    position: [f32; 2],
    uv: [f32; 2],
    color: [f32; 3],
}
현재 Vertex는 패딩이 생기지 않으니 그대로 둔다. Pod는 Zeroable, Copy, Clone을 필요로 하기에 함께 부여한다.
정점 버퍼 레이아웃
정점 버퍼에 데이터가 들어 있어도 어디부터 어디까지가 정점 하나인지, 한 정점 안에서도 어디까지 어떤 값인지 알 수 없다. 따라서 GPU가 이를 알 수 있게 VertexBufferLayout을 사용한다.
array_stride로 어디까지가 한 정점인지 정한다. Vertex의 경우엔 한 정점당 28바이트다. Rust 표준 라이브러리의 std::mem::size_of를 사용하면 타입이나 값의 바이트 크기를 구할 수 있다. 이를 array_stride의 입력 타입인 BufferAddress로 입력하면 된다.
step_mode는 VertexStepMode로 정점 버퍼에서 데이터를 가져오는 순번을 정점 기준으로 할지, 인스턴스 기준으로 할지 정한다. Vertex는 정점마다 다음 데이터를 가져오고, Instance는 각 인스턴스를 기준으로 버퍼에서 데이터를 가져오며, 같은 인스턴스에 속한 모든 정점은 동일한 데이터를 사용한다.
// Suppose that this is our vertex format:
#[repr(C, packed)]
struct Vertex {
    foo: [f32; 2],
    bar: f32,
    baz: [u16; 4],
}

// Then these attributes match it:
let attrs = wgpu::vertex_attr_array![
    0 => Float32x2,
    1 => Float32,
    2 => Uint16x4,
];attributes는 VertexAttribute의 배열로 한 정점 내의 개별 속성을 정할 수 있다. vertex_attr_array 매크로로 더 간단히 해당 배열을 만들 수 있다. 위와 같이 어떤 타입이 몇 개 있는지 적으면 된다. 각 번호는 정점 셰이더 @location 입력과 연결된다.
buffers: &[Some(wgpu::VertexBufferLayout {
    array_stride: std::mem::size_of::<Vertex>() as wgpu::BufferAddress,
    step_mode: wgpu::VertexStepMode::Vertex,
    attributes: &wgpu::vertex_attr_array![
        0 => Float32x2,
        1 => Float32x2,
        2 => Float32x3,
    ],
})],
pub struct GpuState {
surface: wgpu::Surface<'static>,
device: wgpu::Device,
queue: wgpu::Queue,
config: wgpu::SurfaceConfiguration,
size: winit::dpi::PhysicalSize<u32>,
render_pipeline: wgpu::RenderPipeline,
vertex_buffer: wgpu::Buffer,
}Ok(GpuState {
surface,
device,
queue,
config,
size,
render_pipeline,
vertex_buffer,
})RenderPipeline의 vertex 설정 속 buffers 배열 안에 정점 버퍼 레이아웃을 넣고, 정점 버퍼를 포함해 GpuState를 초기화한다.
render_pass.set_vertex_buffer(0, self.vertex_buffer.slice(..));
render_pass.set_pipeline(&self.render_pipeline);
render_pass.draw(0..6, 0..1);
RenderPass 기록 시 set_vertex_buffer로 초기화할 때 포함시킨 buffer_slice를 0번 슬롯에 연결한다. 정점 버퍼를 입력한 슬롯과 buffers 내 VertexBufferLayout이 연결된다. 0번 슬롯의 정점 버퍼는 buffers의 0번째 VertexBufferLayout 설정으로 읽히게 된다. 정점을 6개 사용할 예정이니 draw 또한 수정한다.
struct VertexOut {
    @builtin(position) position: vec4f,
    @location(0) uv: vec2f,
    @location(1) color: vec3f,
}
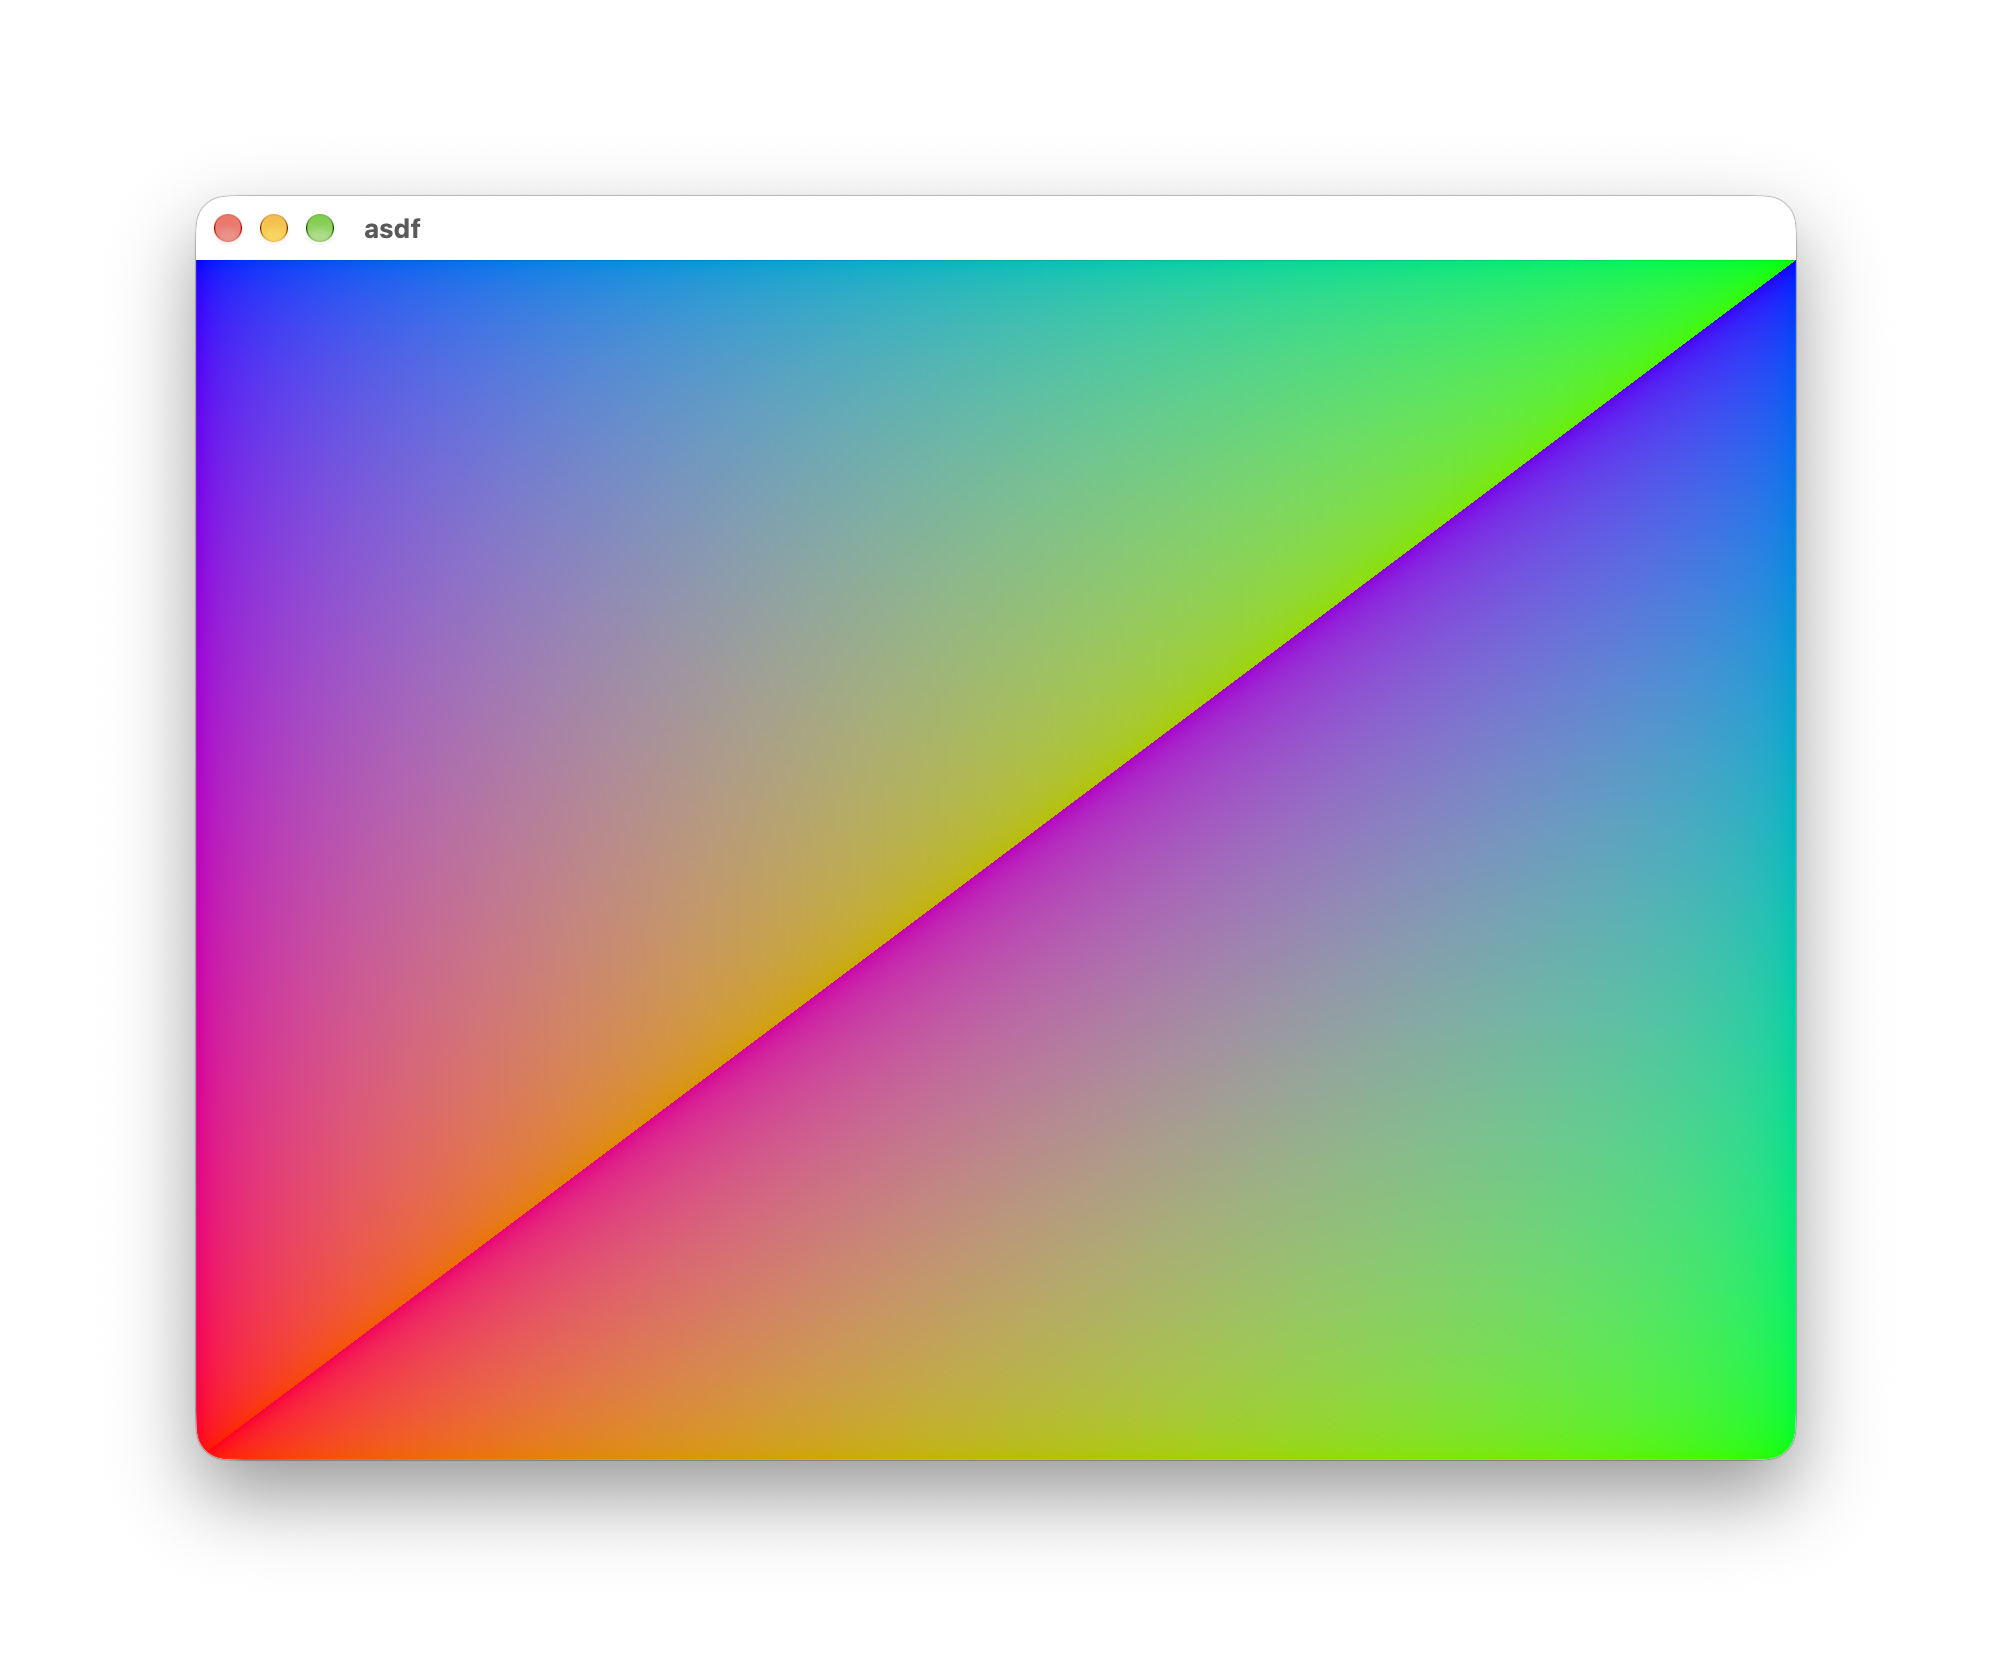
WGSL에서 구조체를 선언한다. 각 필드가 출력될 @location을 정한다. @builtin(position)은 정점 위치를 GPU에 전달하고, @location 0과 1은 프래그먼트 셰이더의 입력 위치 0과 1로 각 값을 전달한다. 각 프래그먼트는 GPU가 보간한 각 값을 입력받게 된다.
@vertex
fn vertex_main(
    @location(0) position: vec2f,
    @location(1) uv: vec2f,
    @location(2) color: vec3f,
) -> VertexOut {
    let clip_position = vec4f(position.xy, 0.0, 1.0);
    return VertexOut(clip_position, uv, color);
}
정점 셰이더 함수에서 앞서 설정한 속성 위치로 각 정점 값을 입력받아 구조체에 할당해 출력하게 한다.
@fragment
fn fragment_main(
    @builtin(position) position: vec4f,
    @location(0) uv: vec2f,
    @location(1) color: vec3f,
) -> @location(0) vec4f {
    return vec4f(0.0, 0.4, 1.0, 1.0);
}
@fragment
fn fragment_main(
    @builtin(position) position: vec4f,
    @location(0) uv: vec2f,
    @location(1) color: vec3f,
) -> @location(0) vec4f {
    // return vec4f(color, 1.0);
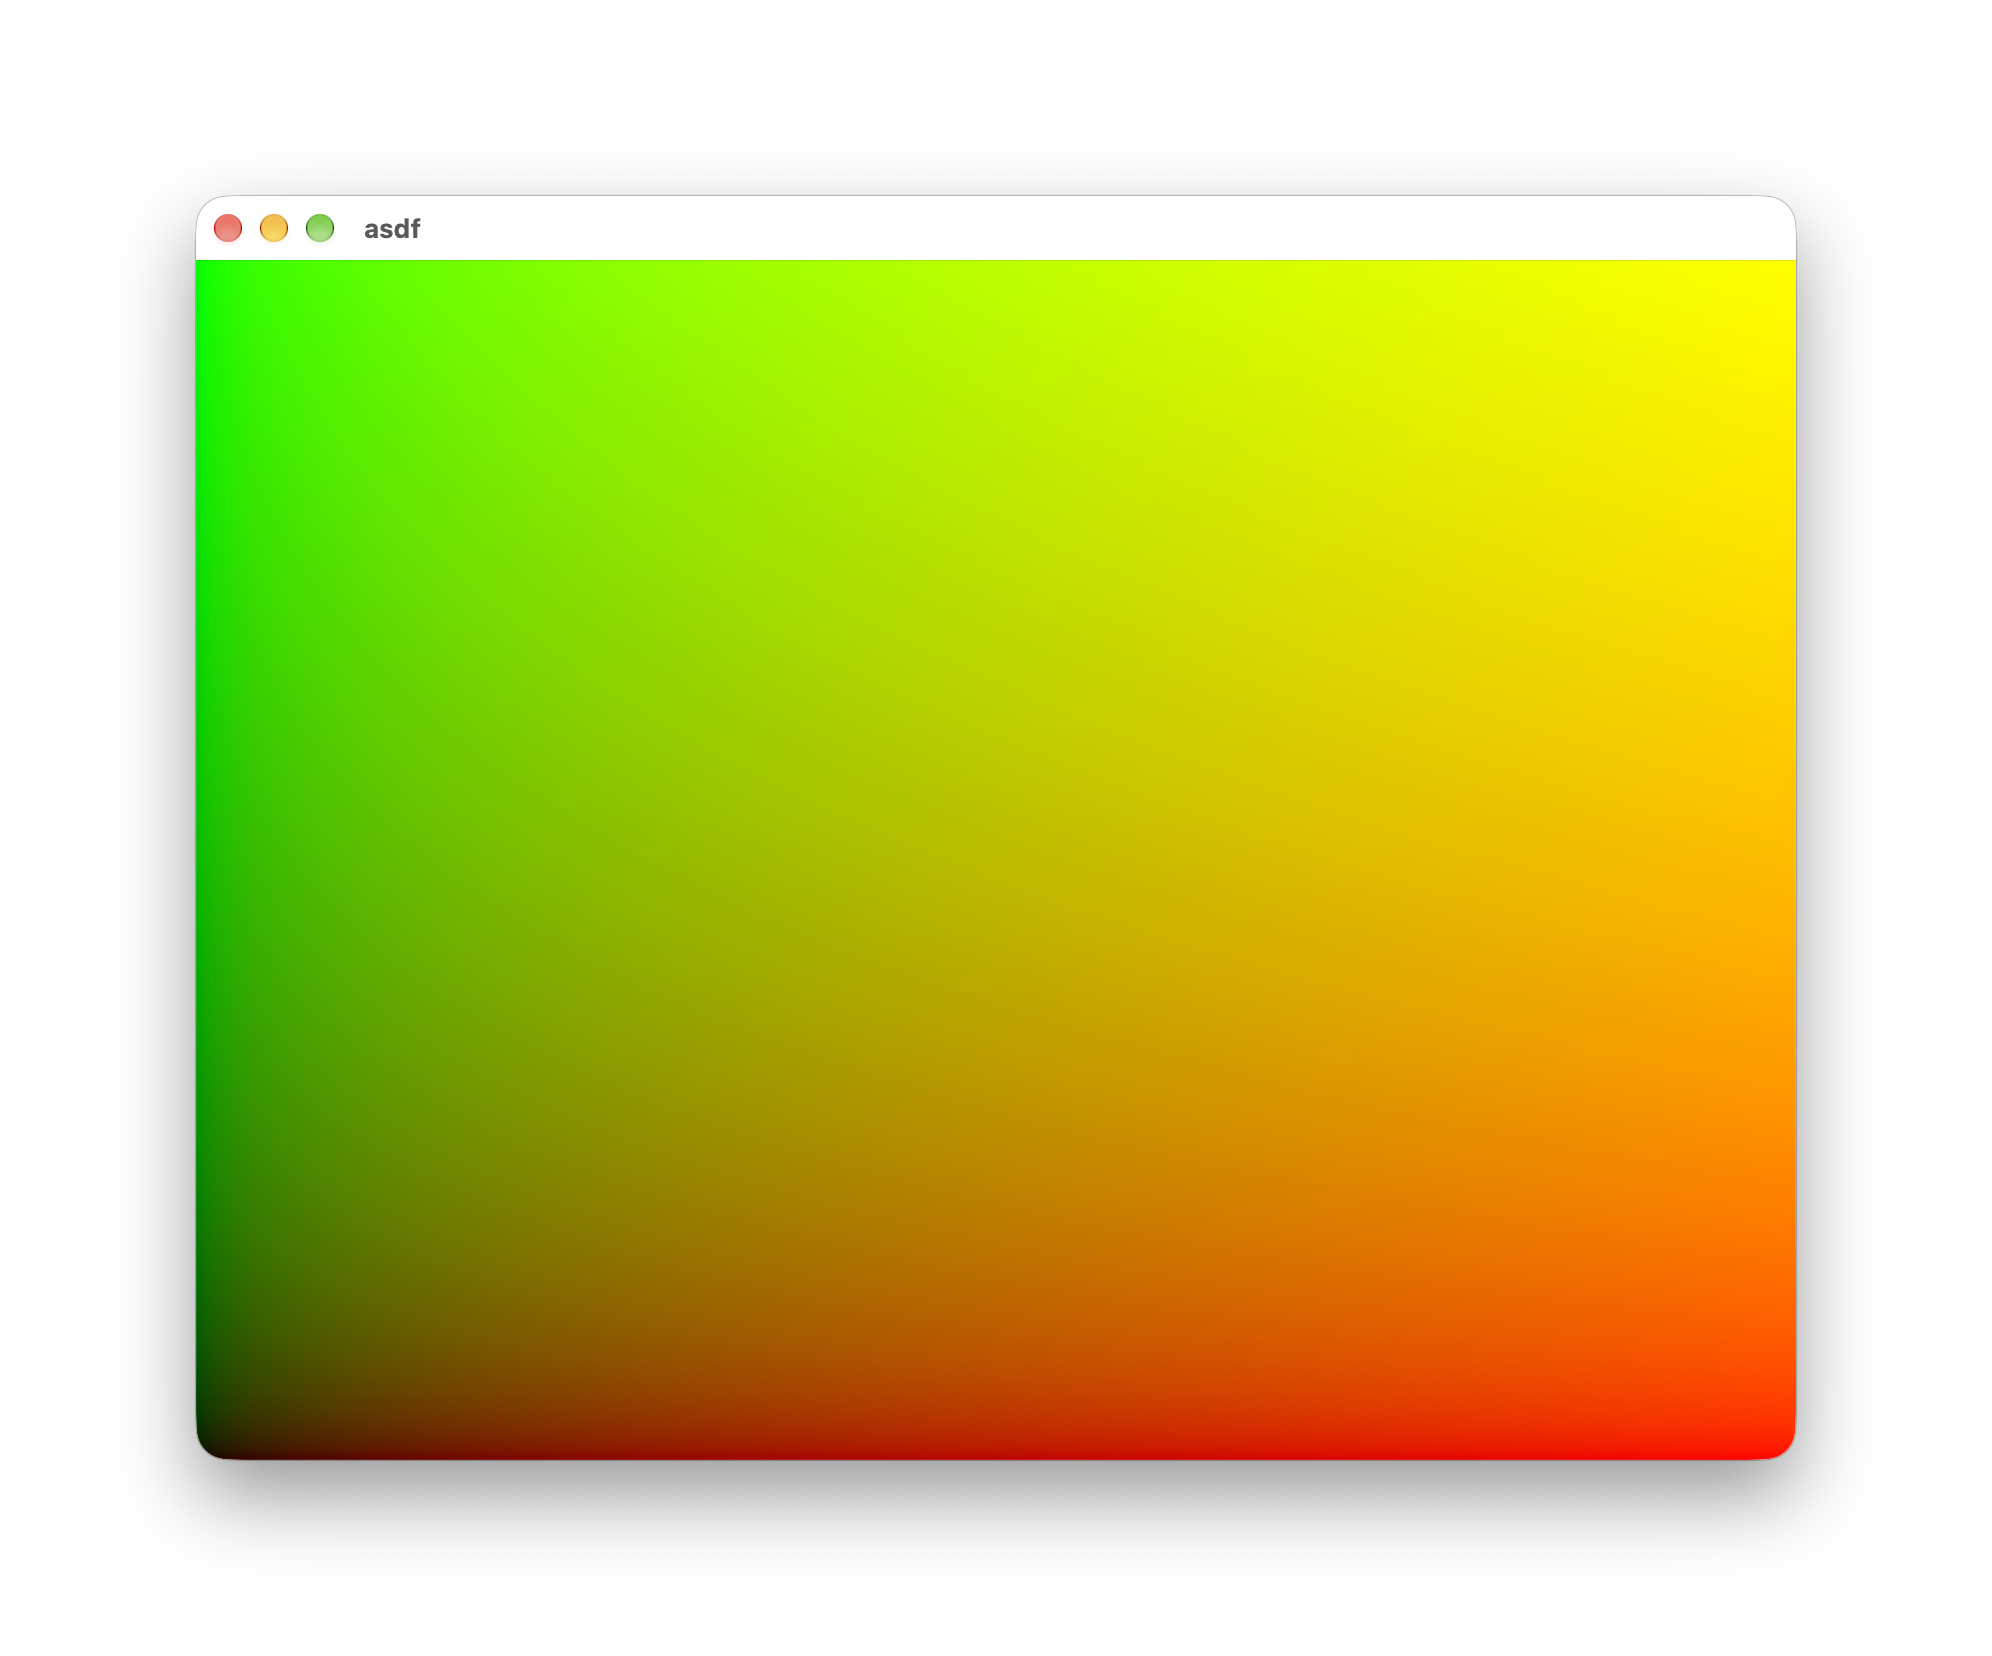
    return vec4f(uv, 0.0, 1.0);
}
각 값을 입력받아 색상 혹은 uv를 출력한다. 프래그먼트별로 보간된 값을 출력하게 된다.
인덱스 버퍼
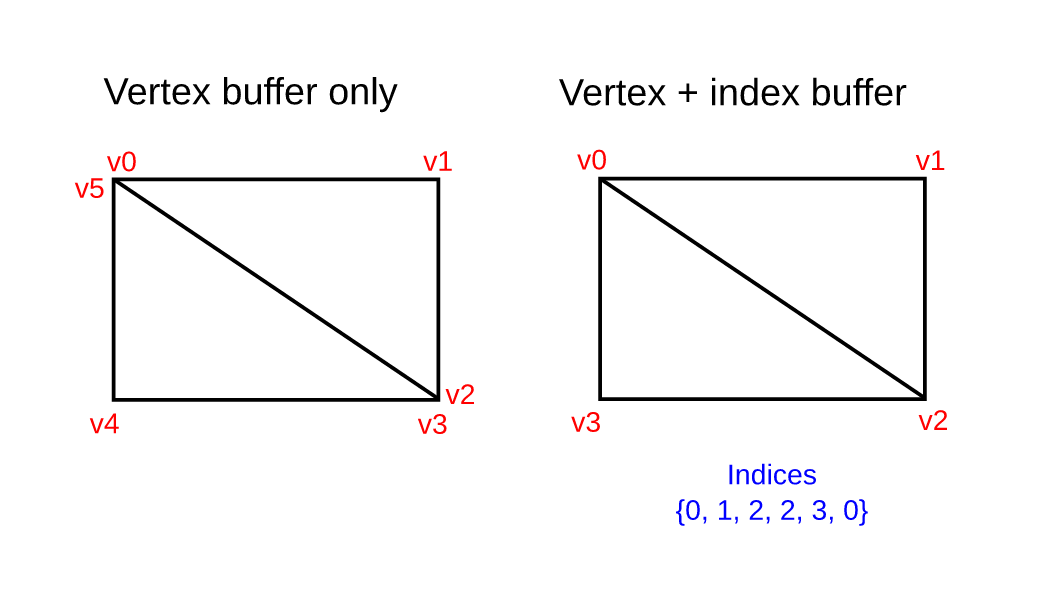
지금은 정점 6개를 입력받아 정점 3개씩 독립된 삼각형을 두 개 그리고 있다. 이때 정점 두 개는 겹치게 된다. 인덱스 버퍼로 정점을 불필요하게 중복해 사용하는 상황을 방지할 수 있다. 인덱스 버퍼에는 정점 사용 순서를 넣고 draw_indexed 메서드로 해당 순번으로 정점을 그리면 된다. 정점 6개를 각각 CCW 순으로 넣고 그리는 방식에서, 정점 4개를 넣고 각 정점을 사용할 순서를 정해 그리는 방식으로 변경한다.
let vertices = [
    Vertex::new([-1.0, -1.0], [0.0, 0.0], [1.0, 0.0, 0.0]),
    Vertex::new([1.0, -1.0], [1.0, 0.0], [0.0, 1.0, 0.0]),
    Vertex::new([1.0, 1.0], [1.0, 1.0], [0.0, 0.0, 1.0]),
    Vertex::new([-1.0, 1.0], [0.0, 1.0], [1.0, 1.0, 1.0]),
];
let indices: [u16; 6] = [0, 1, 2, 0, 2, 3];
let index_buffer = device.create_buffer_init(
&wgpu::util::BufferInitDescriptor {
label: Some("index_buffer"),
contents: bytemuck::cast_slice(&indices),
usage: wgpu::BufferUsages::INDEX,
}
);render_pass.set_vertex_buffer(0, self.vertex_buffer.slice(..));
render_pass.set_index_buffer(self.index_buffer.slice(..), wgpu::IndexFormat::Uint16);
render_pass.set_pipeline(&self.render_pipeline);
render_pass.draw_indexed(0..6, 0, 0..1);정점 버퍼에 입력하는 정점은 4개로, 각 정점의 순번을 정해 BufferUsages를 INDEX로 설정해 버퍼를 만든다. 큰 수가 필요 없으니 인덱스 배열이 지원하는 타입 중 u16을 사용한다. 정점 버퍼처럼 GpuState에 포함시켜 초기화하고 render 내에서 set_index_buffer로 사용한다. IndexFormat은 u16으로 한다. draw 대신 draw_indexed로 사용할 인덱스의 범위, 각 인덱스에 더할 정점 오프셋, 인스턴스 범위를 정해 그린다.
// 이전 정점 두 개와 연결될 수 있도록 지그재그로 순번 변경
let vertices = [
    Vertex::new([-1.0, -1.0], [0.0, 0.0], [1.0, 0.0, 0.0]),
    Vertex::new([1.0, -1.0], [1.0, 0.0], [0.0, 1.0, 0.0]),
    Vertex::new([-1.0, 1.0], [0.0, 1.0], [1.0, 1.0, 1.0]),
    Vertex::new([1.0, 1.0], [1.0, 1.0], [0.0, 0.0, 1.0]),
];
primitive: wgpu::PrimitiveState {
topology: wgpu::PrimitiveTopology::TriangleStrip,
cull_mode: None,
..Default::default()
},더 간단한 방법도 있다. 지금은 PrimitiveTopology가 TriangleList다. 이를 TriangleStrip으로 바꾸면 된다. TriangleList는 정점 세 개당 독립적인 삼각형 하나를 그린다. TriangleStrip은 정점 세 개 이후 정점이 하나 추가될 때 직전 두 개의 정점과 삼각형을 이뤄 그린다. 그럼 인덱스 버퍼 없이 정점 네 개로 사각형을 그릴 수 있다. 지금처럼 화면을 덮는 사각형 하나만 그린다면 이쪽이 더 효율적이다. 단, 정점은 왼쪽 아래, 오른쪽 아래, 왼쪽 위, 오른쪽 위처럼 지그재그 순서로 넣어야 한다. 사각형 둘레를 따라 넣으면 두 번째 삼각형이 사각형을 다 덮지 못한다. 그래도 인덱스 버퍼를 쓰는 쪽이 확장 가능성이 있기에 현재 코드를 유지한다.
vertices[0].uv[0] = 1.0 - vertices[0].uv[0];
vertices[1].uv[0] = 1.0 - vertices[1].uv[0];
vertices[2].uv[0] = 1.0 - vertices[2].uv[0];
vertices[3].uv[0] = 1.0 - vertices[3].uv[0];

queue.write_buffer(&vertex_buffer, 0, bytemuck::cast_slice(&vertices));
버퍼 값을 업데이트해야 한다면 버퍼를 새로 만들 필요 없이 값을 변경한 후 write_buffer로 덮어쓰면 된다.
다음 글로 이어집니다.